 NEXT4I

6 ส.ค. 2026
BuildInPublicSecondBrianKnowledgeManagementAIToolsAI

จาก Post ก่อนหน้า 1.3 ล้าน บรรทัด ใน 10 วัน "N-Flow Agentic Inception" - The NEXT4I Agentic Workflow ที่ผมเล่าถึงโค้ดที่แก้ไปประมาณ 1.3 ล้านบรรทัด (ตอนนี้เป็น 1.8 ล้านบรรทัดไปแล้ว) ใน 10 วัน จาก ticket ทั้งหมด 1,243 ใบ ผมเชื่อว่าหลายคนอ่านแล้วน่าจะคิดในใจว่า “ปล่อย AI ปั่นงานเยอะขนาดนั้น งานไม่เละหรอ?”
คำถามนี้ถูกต้องเลยครับ เพราะตัวเลข 1.8 ล้านนี่แหล่ะ ที่ผมอยากจะสื่อว่ามันมีรายละเอียดซ่อนอยู่ในนั้นเยอะมาก ถ้าแค่สั่ง AI ให้เขียนโค้ดไปเรื่อยๆ ยังไงก็ไม่มีทางได้ตัวเลขนี้ และต่อให้ได้ ก็คงเอาไปใช้อะไรไม่ได้
บทความนี้ผมจะเล่าว่าเบื้องหลังมีอะไรบ้าง และผมเอาหลักการคิดมาจากประสบการ์การทำงานกว่า 15 ปีของผมและเก็บเกี่ยวจากบุคคลรอบตัว มาปรับใช้คุม AI ครับ
ในการทำงานของ N-Flow Agentic Inception ที่ผมกำลังพัฒนา มีโจทย์มากมายหลายอย่างซ่อนอยู่ในนั้น ส่วนนึงก็คือ flow ของการนำ ticket งานไป Implement ซึ่งผมสรุปมาบางส่วนและแจกแจงเป็นข้อๆ ดังนี้ครับ
จะว่าง่ายๆก็คือ ผมประยุกต์การทำงาน แบบสายการผลิต และ SDLC (Software Development Life Cycle ที่ปกติเราใช้กับทีมที่เป็นคนจริงๆอยู่แล้ว) มาใช้กับ AI นั่นเองครับ เสมือนว่าเราเป็น PM/PO แล้วถามตัวเองว่า ต้องมีกลไกอะไรบ้าง ถึงจะไว้ใจให้ทีมทำงานกันเอง แล้วส่งงานได้ถูกต้องและครบถ้วน
ในฐานะ owner และ developer ในเวลาเดียวกัน ผมต้องการเปลี่ยนมุมมองการทำ software ให้เหมือนโรงงานที่มีสายการผลิต แต่ละ ticket วิ่งผ่านสายการผลิตที่ผมวางแผนไว้ แล้วแต่ละสถานีทำหน้าที่ของมัน ให้เป็น SOLID (ผมประยุกต์ใช้ SOLID Principle จาก concept ในการพัฒนา ซอฟต์แวร์ เข้ามาร่วมด้วยครับ)
จากประสบการณ์ในวงการ Software Development ทั้งที่เจอเองและที่ได้ฟังจากคนรอบตัว ผมพอจะสรุปได้ว่า
PO ไม่จำเป็นต้องรีวิว code ทุกบรรทัด (ส่วนใหญ่ไม่รีวิวด้วยซ้ำ)
เขาจะโฟกัสที่ feature หลัก และกล้ามอบหมาย feature หรือ function ย่อยๆ ให้คนที่ไว้ใจมากพอ กล้าไว้ใจทีมให้ไปถึงเป้าหมายด้วยวิธีที่ทีมตัดสินใจเอง
แต่ไม่ได้ให้ไว้ใจได้ลอยๆ นะครับ (owner และหัวหน้าที่ดีต้องรู้จักเชื่อใจลูกน้อง แต่ต้องมีกฎระเบียบและวิธีปฏิบัติที่ดีพอ เป็นตัวคุมความเชื่อใจนั้น)
แล้วอีกสิ่งนึงคือ การที่มีการปรับและแก้ไข Ticket ผมจะไม่ไปแก้ไข ticket เดิม ผมจะปล่อยเป็นประวัติและ Log ไว้แบบนั้น และผมจะสร้าง Ticket ใหม่ เพิ่มเข้ามาเป็น Open-Close ("O" ใน SOLID Principle หมายถึงการเปิดให้ต่อเติม แต่ปิดในการแก้ไข) แล้วจึงค่อยแก้ Requirement Summary ที่เป็นเอกสาร
กับ AI ก็เหมือนกัน ไม่มีทางที่ผมจะอ่าน PR ได้ไหวทั้งหมด สิ่งที่ผมทำได้คือวางกฎ วางสายการผลิต และสร้าง Quality Gate (จุดตรวจคุณภาพที่ ticket ต้องผ่านก่อนจะนับว่าเสร็จ) ให้ดีพอที่จะไว้ใจได้
ผมไม่ได้หมายความว่าไม่ต้องทดสอบ หรือเชื่อผลลัพธ์ที่ออกมาเลยนะครับ กลับกัน ทุก feature และทุก function ต้องผ่านการทดสอบทั้งหมด เพียงแต่ระดับและรูปแบบการทดสอบมันต้องลดหลั่นกันไปตามความเหมาะสมของงานนั้นๆ
ถ้าเทียบกับโรงงาน น็อตทุกตัวต้องผ่าน QC ทั้งหมด แต่ผมที่เป็น owner ไม่จำเป็นต้องหยิบน็อตมาทดสอบเองทุกตัว
ในสายการผลิตของผม การทดสอบหลักคือ TDD (Test-Driven Development คือเขียน test ก่อนเขียนโค้ด) ลำดับคือ
เขียน test ให้ fail ก่อน
      │
      ▼
เขียนโค้ดให้ test ผ่าน
      │
      ▼
ปรับปรุงโค้ด (refactor)
      │
      ▼
เก็บหลักฐาน: ผลตอน fail + ผลตอนผ่าน
จุดสำคัญคือต้องมี หลักฐานทั้งสองฝั่ง คือ หลักฐานตอน fail เพื่อพิสูจน์ว่า test ตรวจงานได้จริง ไม่ใช่ test ที่ผ่านเสมอ (always true) ส่วนหลักฐานตอนผ่านพิสูจน์ว่าโค้ดทำได้ตามที่ ticket สั่ง
อันนี้ คือ "S" ใน SOLID Principle ซึ่งผมชอบมาก (S = Single Responsibility) คือทำแค่เรื่องๆเดียว รับผิดชอบเรื่องเดียว นี่จะเป็นผลดีมากๆ กับ AI เพราะ Context จะถูกพัวพันน้อยมาก เพราะทำอยู่เรื่องๆเดียว แถม ticket นั้นๆยัง scope เล็กอีกต่างหาก
ให้นึกถึงสายการผลิตในโรงงานครับ แต่ละ station ทำแค่เรื่องเดียว เล็กๆสั้นๆ แล้วส่งต่อผ่านสายพาน แบบนั้นจะทำได้เร็วและแม่นยำกว่าให้ station เดียวทำหลายๆอย่าง
ticket ก็เหมือนกัน หนึ่งใบควรเป็นหนึ่งเรื่องย่อยๆ เท่านั้น พอเรื่องเล็ก AI ก็โฟกัสได้ context ไม่บวม และโอกาสหลอนก็น้อยลง นี่คือเหตุผลที่โปรเจกต์นี้มีถึง 1,243 ใบนั่นเอง
ตัว ticket เอง ในแต่ละใบก็ต้องผ่านการตรวจคุณภาพก่อนเข้าสายการผลิตด้วย (ส่วนนี้ขอยังไม่ลงรายละเอียดในบทความนี้ครับ)
อีกข้อที่สำคัญมากคือ ticket แต่ละใบต้องพร้อมถอดเข้าออกและเปลี่ยนได้เสมอ ถ้าใบไหนมีปัญหา ต้องดึงออกจากสายการผลิตได้โดยไม่ทำให้ทั้งสายหยุด และ tracing กับการจัดการ impact ต้องแข็งแรงพอที่จะรู้ว่าดึงใบนี้ออกแล้วกระทบอะไรบ้าง
สั่งงานให้ถูกคนครับ งานบางงานตรงไปตรงมา ไม่ได้ยากหรือซับซ้อน ก็ไม่จำเป็นต้องให้คนที่เก่งที่สุดทำ บางทีคนที่เก่งและคิดนอกกรอบเกินไป อาจทำงานเกินเป้าหมายที่เราวางไว้ หรือคิดเยอะเกินจำเป็น
กับ AI ก็เหมือนกัน งานง่ายๆ ผมให้ model รองๆ ลงมาทำ แถมยังประหยัดต้นทุนด้วย และฝ่ายผลิตควรคิดให้น้อย เน้นทำตามคำสั่งใน ticket มากกว่าคิดเอง เพราะการคิดเรื่องโครงสร้างเกิดขึ้นไปแล้วตอนวางแผนและแตก ticket (อันนี้ ได้แรงบันดาลใจมาจาก scrum ใน event Refinement, Planning แต่ผลลัพท์เพื่อให้ได้มาซึ่ง ticket หลายๆ ใบ ที่วางแผนมาแล้วพร้อมโยนให้ AI)
ส่วนงานที่ยากขึ้น ค่อยส่งให้ model ที่เก่งกว่าและแพงกว่า ใน workflow ของผม แต่ละระดับ (tier) มีเพดานค่าใช้จ่ายของตัวเอง ถ้างานไหนจะขึ้นไปใช้ tier ที่แพงเกินเพดาน ผมต้อง approve ก่อน ไม่ปล่อยให้ค่าใช้จ่ายบานปลาย หรืออาจสรุปได้ว่า งานใหญ่หรือ ซับซ้อนเกินไป ต้องแตกย่อยลงมาอีก
เราต้องกล้าเชื่อใจ Quality Gate และกล้าไว้ใจการ implement ครับ แต่ก่อนจะกล้า ต้องวางแผนมาดีพอ และตัวคุมคุณภาพต้องเข้มข้นพอดีกับงาน
บางงานควรมี solution ที่เหมาะสมให้ตั้งแต่ใน ticket และมีขั้นตอนทดสอบหรือ QC ที่พอกับงานนั้น แต่การคุมที่แน่นเกินไปก็ต้อง trad-off เพราะว่าอาจทำให้งานไม่ออกเลย หรือซับซ้อนเกินความจำเป็น
ถ้าจะให้เปรียบเทียบให้เห็นภาพ คล้ายๆ โรงงานผลิตแร่ครับ โรงงานที่ทำแร่บริสุทธิ์ 99.9999% กับโรงงานที่ทำแร่ 95% ระบบต่างกันมาก ทั้งเครื่องจักร ขั้นตอน และต้นทุน ถ้างานเราต้องการแค่ 95% แต่ไปสร้างโรงงาน 99.9999% ก็เสียทั้งเวลาและเงินโดยไม่จำเป็น
ในโรงงานจะมีเครื่องดีดสินค้าที่คุณภาพไม่ผ่านออกจากสายการผลิต ในมุม AI Factory ของผม ก็มีกลไกได้อีกขั้น เช่นส่งให้ model ที่ฉลาดกว่าเข้ามาช่วยดูก่อน ถ้ายังไม่ผ่านอีก ก็อาจต้องตีตกให้คนรีวิว แล้วเริ่มกระบวนการใหม่
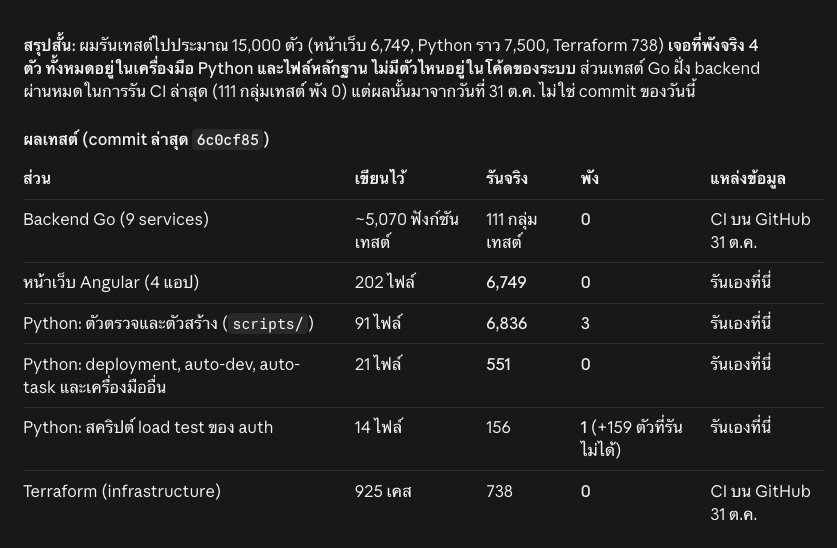
ตัวเลขจาก log ของโปรเจกต์นี้ (นับถึงวันที่ 30 ตุลาคม 2026) จะเห็นภาพว่า gate ตีงานกลับจริงๆครับ
DONE_WITH_CONCERNS (เสร็จแต่ยังมีข้อกังวล) ระบบเลย escalate ขึ้น tier ที่สูงกว่าให้เอง ประมาณ 106 ครั้ง รองลงมาคือ validation หรือ test ไม่ผ่าน ประมาณ 63 ครั้งผมมองว่าตัวเลข 12.6% นี้เป็นเรื่องที่ดีนะครับ เพราะถ้า gate ไม่ตีอะไรกลับเลย ผมจะเริ่มสงสัยตัว gate เองมากกว่า ว่าควบคุมคุณภาพได้ดีพอไหม
แต่ตัวเลขนี้ก็ต้องอ่านพร้อมข้อจำกัดที่ว่างานที่ปิดด้วยสถานะ DONE_WITH_CONCERNS ยังต้องมีคนหรือ command จริง ยืนยันหลักฐานอีกที เช่น load test ที่ยังไม่ได้วัดจริง ส่วนนี้ยังเป็นงานของคน หรือ human in the loop นั่นเองครับ
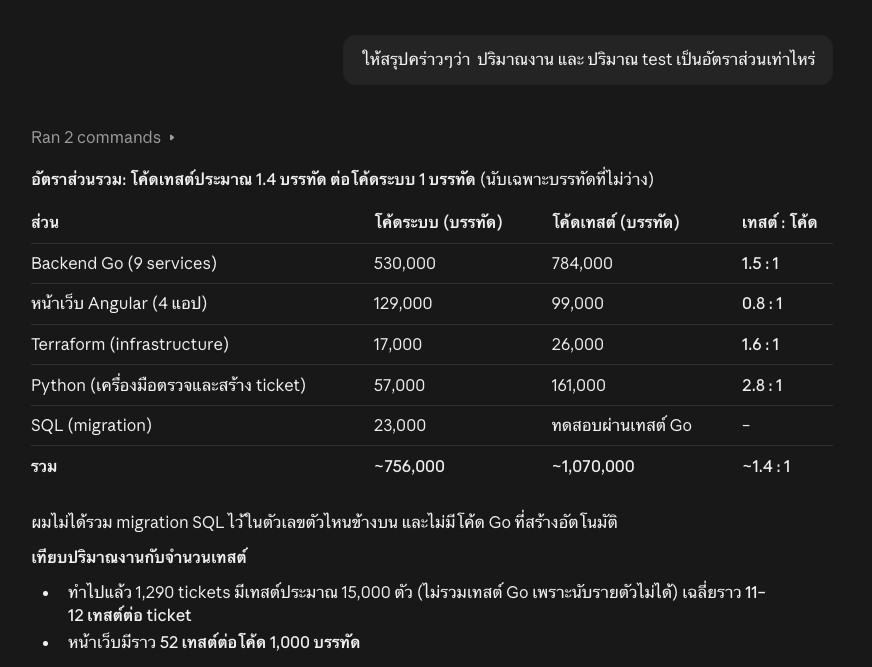
ตัวเลข 1.7-1.8 ล้านบรรทัดใน 10 วัน ที่ผมบอกไปในตอนแรก ไม่ได้มาจากการสั่ง AI แบบทิ้งๆขว้างๆ แต่ว่า มันมาจากสายการผลิตที่วางไว้ ticket ที่เล็กพอ model ที่เหมาะกับงาน และ Quality Gate ที่กล้าตีงานกลับ
สุดท้ายแล้ว คนที่เป็นเจ้าของโรงงานต้องวางแผนและสร้าง Quality Gate ให้ดีพอ เพราะเมื่อไหร่ที่เรายังไม่มั่นใจใน ตัวควบคุม หรือผลลัพธ์ งานออกมาไม่ถูกต้อง ไม่ถูกใจ เราก็ต้องกลับไปปรับโครงสร้างใหม่ เรื่อยๆ อยู่แล้ว
และแน่นอนว่ามันอาจต้องพังก่อนและไม่สำเร็จก่อน ซึ่งมันคือธรรมชาติของการพัฒนาระบบ ตามหลักของ SDLC นั่นเองครับ


ลงชื่อเพื่อรับแจ้งเตือน และร่วมเป็นผู้ใช้งานกลุ่มแรกพร้อมรับสิทธิพิเศษ
Drop your email to get notified. Early access members get exclusive perks!
We hate spam as much as you do. Only big updates, no junk.
No subscriptions. No annual fees. No lock-ins.